
Key Takeaways
- RAG(検索拡張生成)とは、生成AIが回答を作る前に社内文書などの資料を検索し、見つかった内容を根拠にして答える仕組みである。
- RAGが消すのは誤答そのものではなく根拠を確認できない状態で、出典表示と「文書に無い」と言わせる設計を入れても人の確認工程は残る。
- RAGが向くのは答えが社内のどこかに文書として存在する業務で、集計や判断を伴う業務はデータ分析や人の領域として切り分ける。
- 精度はAIの性能より文書の準備で決まり、新旧混在・スキャン画像・言葉の食い違い・断片化による文脈落ち・暗黙知の5つに集約される。
- 文書量が少なければ全文を渡す方式で足りることがあり、導入は対象1領域と想定質問集から始めて出典表示と修正ループを運用に組み込む。
RAG(Retrieval-Augmented Generation・検索拡張生成)とは、生成AIが回答を作る前に社内文書などの資料を検索し、見つかった内容を根拠にして答える仕組みです。
「就業規則や製品マニュアルについてAIに聞けるようにしたい」と考えて調べ始めると、RAGという語にすぐ行き当たります。ただ解説の多くは仕組みの図で止まっていて、自社の文書でどこまで正しく答えるのか、何を先に整えるべきかは読み手に委ねられたままです。RAGを最初に提案した2020年の論文と主要クラウド各社の公式文書で限界を確かめたうえで、自社の文書が全文を渡す方式で足りる段階かRAGを組む段階かを切り分ける基準までを書きました。
引用した数値は各社の公式文書と白書・調査報告に書かれた値をそのまま載せています。Anthropicの精度改善値は同社が自社のベンチマークで測った値で、他社製品や貴社の文書で同じ改善が出ることを示すものではありません。
RAGを入れても生成AIの誤答はゼロにならず、変わるのは「根拠を確認できる状態」になることである
生成AIには、知らないことを知っているかのように答える性質があります。この性質は幻覚(ハルシネーション)と呼ばれます。AWSの公式解説は大規模言語モデルの既知の課題として「答えを持っていないときに誤った情報を提示する」「具体的で最新の回答が期待されているのに古い情報や一般論を返す」「権威のない情報源から回答を作る」「用語の混同で不正確な回答を作る」の4つを挙げ、RAGをこれらへの対処として位置づけています(AWS「What is RAG (Retrieval-Augmented Generation)?」・2026年9月16日確認)。
RAGを最初に提案した論文も、狙いを同じ場所に置いていました。Lewisら12名の研究者が2020年5月にarXivへ投稿し同年のNeurIPSで発表した論文は、事前学習済みモデルの未解決課題として「判断の根拠(provenance)を示すこと」と「世界知識を更新すること」を挙げています。そのうえで、モデル内部の記憶(パラメトリック記憶)とWikipediaの索引という外部の記憶(非パラメトリック記憶)を組み合わせる方式をRAGと名づけました(Lewis et al. "Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks"・arXiv v1は2020年5月22日)。論文が報告した効果は、検索を伴わない同種のモデルと比べて「より具体的で多様で事実に即した文章を生成した」というもので、誤答が無くなったとは書かれていません。
ここで線を引いておきたいのは、RAGが消すのは誤答そのものではなく「根拠を確認できない状態」だという点です。AWSは利点として「出典を添えて正確な情報を提示できる」ことを挙げています。Anthropicの公式ガイドも引用元を示させる・提供した文書だけを使わせる・分からないときは分からないと言わせるといった手法を並べたうえで、これらは幻覚を大きく減らすが完全には無くさないと明記しています(Anthropic「Reduce hallucinations」・2026年9月16日確認)。RAGを入れた後も人が確認する工程が残るのはこのためで、確認を省くための仕組みとして導入すると期待外れになります。
日本企業の懸念とも重なります。総務省の令和8年版情報通信白書は生成AI活用で懸念されるリスクとして、日本では「社内情報の漏洩などのセキュリティリスクがある」が最も多く、次いで「出力結果の精度に問題がある」が続くと報告しています(令和8年版情報通信白書 第Ⅰ部第2章第1節(4)・2026年7月24日公表)。RAGは2番目の懸念に対する現実的な手段ですが、1番目の懸念は検索対象の文書を誰に見せるかというアクセス制御の設計で別に手当てする必要があります。この点は文書の準備の節で扱います。
RAGは「調べてから答える」仕組みで、文書の取り込みから索引化・検索・生成までの工程に分かれる
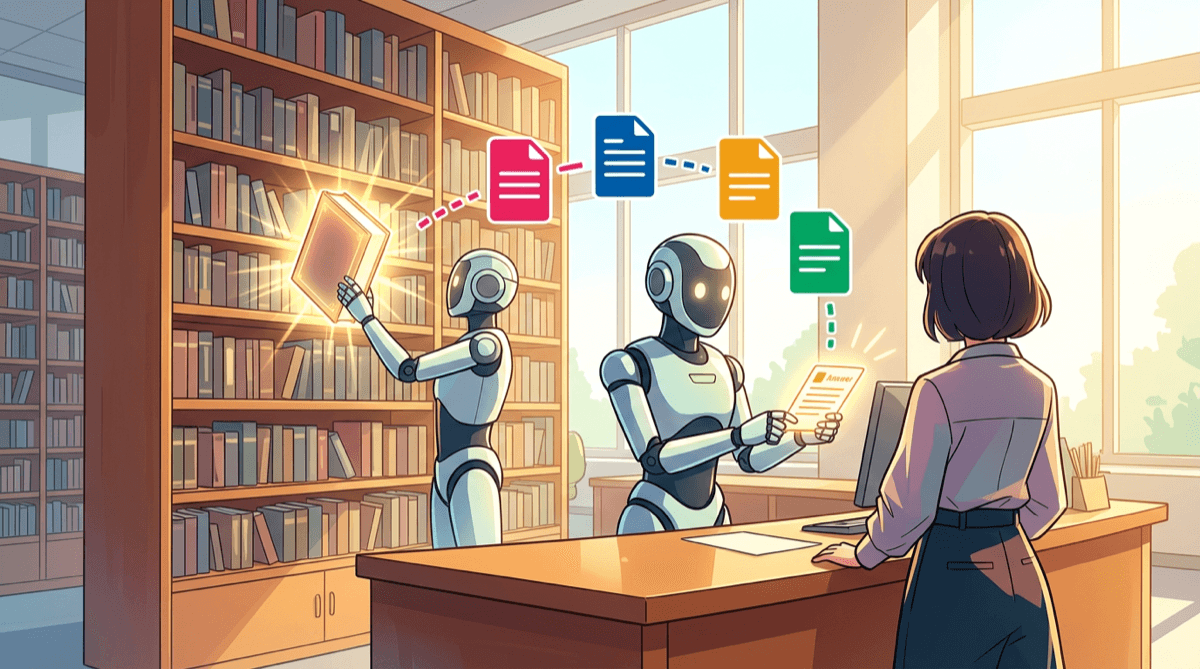
図書館のレファレンス司書を思い浮かべると掴みやすい仕組みです。優秀な司書は質問を受けるとまず書庫から関連資料を探し出し、その資料を根拠に答えます。RAGはこれをAIにやらせる技術で、利用者の目に見える動きは次の3つです。
- 質問を受け取る(「育休は何日前までに申請?」)
- 社内文書の中から関連する箇所を検索する(就業規則の該当条文)
- 見つかった文書を根拠としてAIが回答を組み立てる
Google Cloudの公式文書は、この裏側を6段階で説明しています。文書の取り込み(ローカルファイルやクラウドストレージから)→変換(文書をチャンクと呼ぶ断片に分割)→埋め込み(断片を意味を表す数値列に変換)→索引化(検索用のコーパスを作る)→検索(質問に関係する断片を探す)→生成(見つかった断片を文脈として回答を作る)の順です。同文書は「LLMは組織のデータのような私的な知識を理解していない」ことをRAGが解く課題として挙げ、文脈に自社の情報を足すことで幻覚を減らしより正確に答える助けになると書いています(Google Cloud「RAG Engine overview」・2026年9月3日更新)。
AWSは同じ流れを「外部データの作成→関連情報の検索→プロンプトの拡張→外部データの更新」の4段階でまとめています。最後の「更新」を工程に含めている点は覚えておく価値があります。文書が変われば索引も作り直す必要があり、この工程を持たない導入は時間とともに古い規程を答えるようになるからです。
ポイントは、AIの「記憶」に頼らず毎回資料を見てから答えることです。モデルそのものを学習し直す方法(ファインチューニング)と違い、文書を差し替えれば次の質問から回答が変わります。なお、RAGが検索するのは文書ですが、社内システムのデータベースや業務ツールをAIから直接呼び出させたい場合は別の規格が要ります。その役割を担うのがMCPで、両者の違いはMCPとは?AIとツールをつなぐ共通規格に書いています。
RAGが向くのは「答えが社内のどこかに文書として存在する」業務で、集計と判断は別の領域である
業務での代表例は次の4つです。
- 社内ナレッジQ&A:就業規則・経費規程・業務マニュアルへの質問に即答する社内チャット
- 問い合わせ対応の支援:顧客からの質問に対し、製品マニュアルや過去のQ&Aを根拠に回答案を作る
- 契約書・仕様書の照会:大量の文書から「この条件はどの契約に入っていたか」を探して答える
- 営業ナレッジの活用:過去の提案書・商談記録から、類似案件の知見を引き出す
共通するのは「答えが社内のどこかに文書として存在する」ことです。中小企業がまず自動化すべき業務の筆頭に挙げた「問い合わせ・社内質問への一次対応」は、まさにRAGの主戦場です。
日本企業でも、社内ヘルプデスクと情報検索はすでに生成AIの主な用途に入っています。総務省の白書によると、業務類型ごとの生成AI活用を尋ねた結果で「社内ヘルプデスク」での活用を答えた日本企業は約5割でした(令和8年版情報通信白書 第Ⅰ部第2章第1節(3)・2026年7月24日公表。活用方針を「わからない」と答えた企業を除いた集計)。IPAの調査でも、AIを導入・試験利用・検討中の企業のうち、用途として「情報検索・収集・分析・レポーティング」を挙げた割合は77.0%に上ります(IPA「DX動向2026」報告書 図表3-9・2026年7月30日公開・有効回答1,799社・調査期間2026年4月中旬〜6月中旬)。どちらもRAGが担う典型的な業務です。
一方で、次の3つはRAGの外側にあります。
- 文書にないことは答えられない:資料が存在しない質問には、正しく作られたRAGほど「情報がありません」と返します
- 集計・推論は苦手:「先月の売上上位10商品は?」のような集計はRAGではなくデータ分析の領域です
- 判断は人に残る:規程の例外を認めるかどうかのような判断は、根拠を見つけた後に人が下します
向く業務と向かない業務の境目は「答えが文書に書いてあるか」の一点です。書いてあれば探させ、書いていなければ計算させるか人が判断する。この切り分けが導入の最初の設計になります。
RAGの精度はAIの性能よりも文書の準備で決まり、つまずきは5つに集約される
Microsoftの公式文書は、RAGの品質は検索のために文書をどう準備するかで決まると述べています。同文書が挙げるRAGの課題は質問の理解・複数の保管場所にまたがるデータ・LLMに渡せる文字数の上限・応答時間・セキュリティとガバナンスの5つで、モデルの賢さはそこに入っていません(Microsoft Learn「RAG and generative AI - Azure AI Search」・2026年8月4日更新)。
準備の実態は、日本では心もとない数字です。IPAの調査ではAI利活用に向けた学習データを「整備しておりAIに活用している」企業は7.0%にとどまり、整備が不十分か未着手と答えた企業が過半でした。同じ調査は、整備して活用している企業のほとんどが期待と同等かそれ以上の効果を得ていることも報告しています(IPA「DX動向2026」報告書 図表3-15・2026年7月30日公開)。設問の語は「学習データ」ですが、RAGで参照させる文書の整備も同じ準備工程にあたります。総務省の白書も同じ方向を指しています。組織的に生成AIへ取り組む企業に絞った集計で米国・ドイツ・中国では「生成AIに社内データを学習させたり、生成AIが参照可能なデータベースを構築したりしている」企業が5割を超え、日本より大幅に高いと指摘しています(令和8年版情報通信白書 第Ⅰ部第2章第1節(2)・2026年7月24日公表)。AIが参照する土台を先に作った企業は、日本ではまだ少数です。
RAG導入でつまずく原因はAIの設定ではなく文書の状態にあり、次の5つに集約されます。
- 同じ規程の新旧が混在している:AWSが挙げる「古い情報を返す」課題そのもので、どちらを根拠にするかをAIは判断できません。更新の工程を持つことが対策です
- スキャン画像や表のままで読めない:Microsoftの文書は画像とPDFにはOCRと画像解析、大きな文書には分割が要ると整理しています。紙をそのまま取り込んでも索引は作れません
- 質問の言葉と文書の言葉が違う:Microsoftの例では、利用者は「リモート勤務者のPTO(有給)」と聞くのに文書は「time off」「telecommute」と書いてあり、語の一致に頼る検索は外れます。同義語辞書や意味で照合する検索の併用が対策です
- 断片に切ると文脈が落ちる:Anthropicは、文書を断片に分けたときに「同社の売上は前四半期比3%増」という断片だけでは会社名も時期も分からなくなる例を挙げています。各断片に文脈を書き足してから索引化する手法(Contextual Retrieval)を同社のベンチマークで測ると、上位20件に正解が含まれない割合は5.7%から3.7%へ下がりました(35%減。Anthropic「Introducing Contextual Retrieval」・2024年9月19日公開)。キーワード検索や並べ替え処理を足すとさらに下がったと同社は報告しています。同社の測定条件での値で、文書の分け方ひとつで検索の外れ方が変わることを示す例として読んでください
- 「本当の運用ルール」が文書化されていない:ベテランの頭の中にある手順は検索できません。この場合に必要なのはRAGではなく、まず文書を書く仕事です
もう一つ、精度とは別に先に決めるべきことがあります。Microsoftの文書は、私的な文書をLLMに開くには細かなアクセス制御が要り、利用者もAIエージェントも権限のある文書だけを取得できる状態でなければならないと述べています。例として挙がるのは、役員がチャットボットに聞いても財務データは財務チームにしか見せないという設計です。誰がどの文書を検索できるかは、AIの利用ルールと同じ枠で決めておく必要があります。線の引き方は生成AIの社内利用ルールの作り方に、文書や記録をAIが読める形に整える進め方は脱Excelの進め方に書いています。
つまりRAG導入は、社内ナレッジの棚卸しと整備のプロジェクトでもあります。逆に言えば、この整備自体がAIと関係なく会社の資産になります。
導入は対象1領域と想定質問集から始め、出典表示と修正ループを運用に組み込む
RAGの導入も、AI導入の進め方8ステップと同じく小さく始めるのが鉄則です。ただし着手の前に、文書量を一度測っておく価値があります。Anthropicは2024年9月時点で、ナレッジベースが20万トークン(約500ページ)より小さければ全文をプロンプトに入れればよくRAGは要らないと書いています(前掲「Introducing Contextual Retrieval」)。2026年9月16日時点でClaude Opus 5とClaude Sonnet 5のコンテキストウィンドウ(一度に渡せる文字数の上限)は100万トークンで(Anthropic「Models overview」)、渡せる上限は当時より広がっています。ただしAnthropicが全文投入の目安として示している数字は、この20万トークンの記述までです。Microsoftが課題に挙げるとおり文書を丸ごと渡すとトークンを浪費し回答の質も落ちるため、規程1冊程度なら全文を渡して試し、文書が育ってきた段階でRAGへ移す判断が要ります。
順番は次の4つです。
- 対象を1領域に絞り、文書量を測る:全社文書を一気に入れず「経費規程だけ」「製品マニュアルだけ」から始めます。ここで測った文書量が、全文を渡す方式で足りるかRAGを組むかの分かれ目になります
- 想定質問集で正答率を測る:現場から「よくある質問」を集め、答えと根拠文書の所在を人が先に書いておきます。これが導入前の実測になり、AIの回答を採点する基準にもなります
- 出典表示と「文書内に情報がありません」を必須にする:Anthropicのガイドが挙げる、引用元を示させる・提供した文書だけを使わせる・分からないと言わせるの3点をそのまま設計に入れます。利用者が根拠を開いて確かめられる形にしなければ、最初の節で述べた「根拠を確認できる状態」になりません
- 誤答が出たら文書側を直す運用を作る:AWSが工程に含める「外部データの更新」を誰がいつやるかまで決めます。誤答の多くは文書の不備の発見なので、直すのはプロンプトではなく文書です。このループが社内で回るかどうかが定着の分かれ目で、止まる典型はAI導入が定着しない理由と対策に、社内で回し続ける体制の作り方は内製化のロードマップに書いています
RAGのビジネス活用でよくある質問
Q. RAGを入れれば生成AIの誤答はなくなりますか?
なくなりません。RAGが変えるのは根拠を確認できるかどうかで、出典表示と「文書に無い」と言わせる設計を入れても人の確認工程は残ります。詳しくは最初の節に書いたAWSとAnthropicの公式文書の記述をご覧ください。
Q. RAGとファインチューニング(追加学習)はどちらを選ぶべきですか?
社内文書に答えさせる用途では、まずRAGです。ファインチューニングはモデル内部の記憶を書き換える方法で、文書が変わるたびに学習し直す必要があります。RAGは文書を差し替えれば次の質問から回答が変わり、根拠も示せます。最初の節で引いた原論文の、モデル内部の記憶と外部の索引を組み合わせるという区別がそのまま答えです。
Q. 社内文書が少ない場合でもRAGは必要ですか?
必要とは限りません。文書量が小さければ全文をプロンプトに渡す方式で足りることがあり、導入の節の冒頭に目安を書きました。検索の仕組みを組むのは、文書が増えて全文を渡す方式では回答の質が落ちてからで間に合います。
Q. 部署ごとに見せてよい文書が違う場合はどう設計しますか?
検索の段階で利用者の権限に応じて対象文書を絞る設計にします。文書の準備の節で引いたMicrosoftの文書が述べるとおり、利用者もAIも権限のある文書だけを取得できる状態が前提です。これは精度の問題ではなく利用ルールの問題なので、AIの社内利用ルールと同じ場で決めてください。
SAIの視点:RAGの相談で最初に聞くのは、いま誰がその質問に答えているかである
AIに答えさせたい質問を持ち込まれたとき、私たちはその質問にいま誰がどう答えているかを尋ねます。答えている人が規程を暗記して答えているなら文書化が先で、共有フォルダの新旧を見比べてから答えているなら整理が先です。誰も即答できず問い合わせが総務や情報システム部門に集まっているなら、その問い合わせの履歴が想定質問集の原型になります。回答者の側から見ると、文書の状態と着手点が一度に見えてきます。
株式会社SAIのAI導入支援では、RAGを文書の棚卸しから始めます。想定質問集を作って正答率を測り、出典表示と「文書に無い」と言わせる設計を入れ、誤答を文書側で直す運用が社内で回るところまでが支援の範囲です。文書の整理や索引の作り直しをエンジニアが現場で一緒に進める形はFDE伴走開発に書いています。
ご相談の際は、AIに答えさせたい質問を数件と、その答えが載っている文書の名前と保管場所をお問い合わせに書き添えてください。文書の量と状態を見て、全文を渡す方式で足りるかRAGを組む段階かをその場で切り分けます。